논문 폴더가 늘어날수록 첫 장을 여는 일이 더 어려워질 때가 있어요. 여기서는 “우리 연구에서 AI 코딩 도구의 생산성 효과를 어떻게 설명할까?”를 고민하는 대학원생을 가정해요. 공개 논문 10편을 직접 분류한 완성 선별표 (ZIP: literature-screening.csv)를 만들고, 이번 주에 읽을 세 편까지 정해 볼게요. 이 목록은 체계적 문헌고찰의 전체 검색 결과가 아니라 선별 판단을 연습하기 위한 제한된 예제예요.
첨부 링크는 이 글의 예제 ZIP으로 연결돼요. 압축을 푼 뒤 링크에 표시된 파일을 열면 입력·코드·완성 자료를 함께 사용할 수 있어요.
인용 수를 보기 전에 질문의 명사를 고쳐요
처음 질문은 “AI가 개발자를 더 생산적으로 만들까?”였어요. 이 문장으로는 코드 자동 생성 성능, 개발자의 만족도, 완료 시간 연구가 모두 같은 줄에 들어가요. 논문마다 다른 일을 답하므로 읽고 나서도 판단이 어려워져요.
예제에서는 질문을 “AI 코딩 도구의 접근 허용이 사람의 코딩 작업 완료 시간 또는 업무 산출량에 미치는 효과는 어떤 조건에서 달라질까?”로 바꿨어요. ‘사람’, ‘비교 조건’, ‘측정값’이 생기면 선별 이유를 적을 수 있어요. 문헌고찰에서도 주제와 범위를 정하고 검색 기록을 남기는 일이 출발점이에요. Pautasso의 문헌고찰 안내, Rule 1·2를 참고하되, 아래 판정 체계는 이 예제를 위해 만든 작업 방식이에요.
검색 기록에는 2026년 10월 13일, 공개 웹 검색, AI coding productivity randomized controlled trial과 neural code completion productivity를 남겼어요. 검색 결과와 핵심 논문의 참고문헌에서 10편을 골랐고, 검색엔진의 모든 결과를 수집한 것은 아니에요. 발행 연도는 2021~2025년 자료로 제한했어요. 최신 도구의 성능을 결론내리는 조사가 아니라, 연구 조건을 읽는 연습이기 때문이에요. 이 범위를 나중에 바꾸면 이전 선별을 그대로 재사용하지 않고 이유도 다시 검토해야 해요.
‘관련 있어 보인다’를 네 가지 판정으로 나눠요
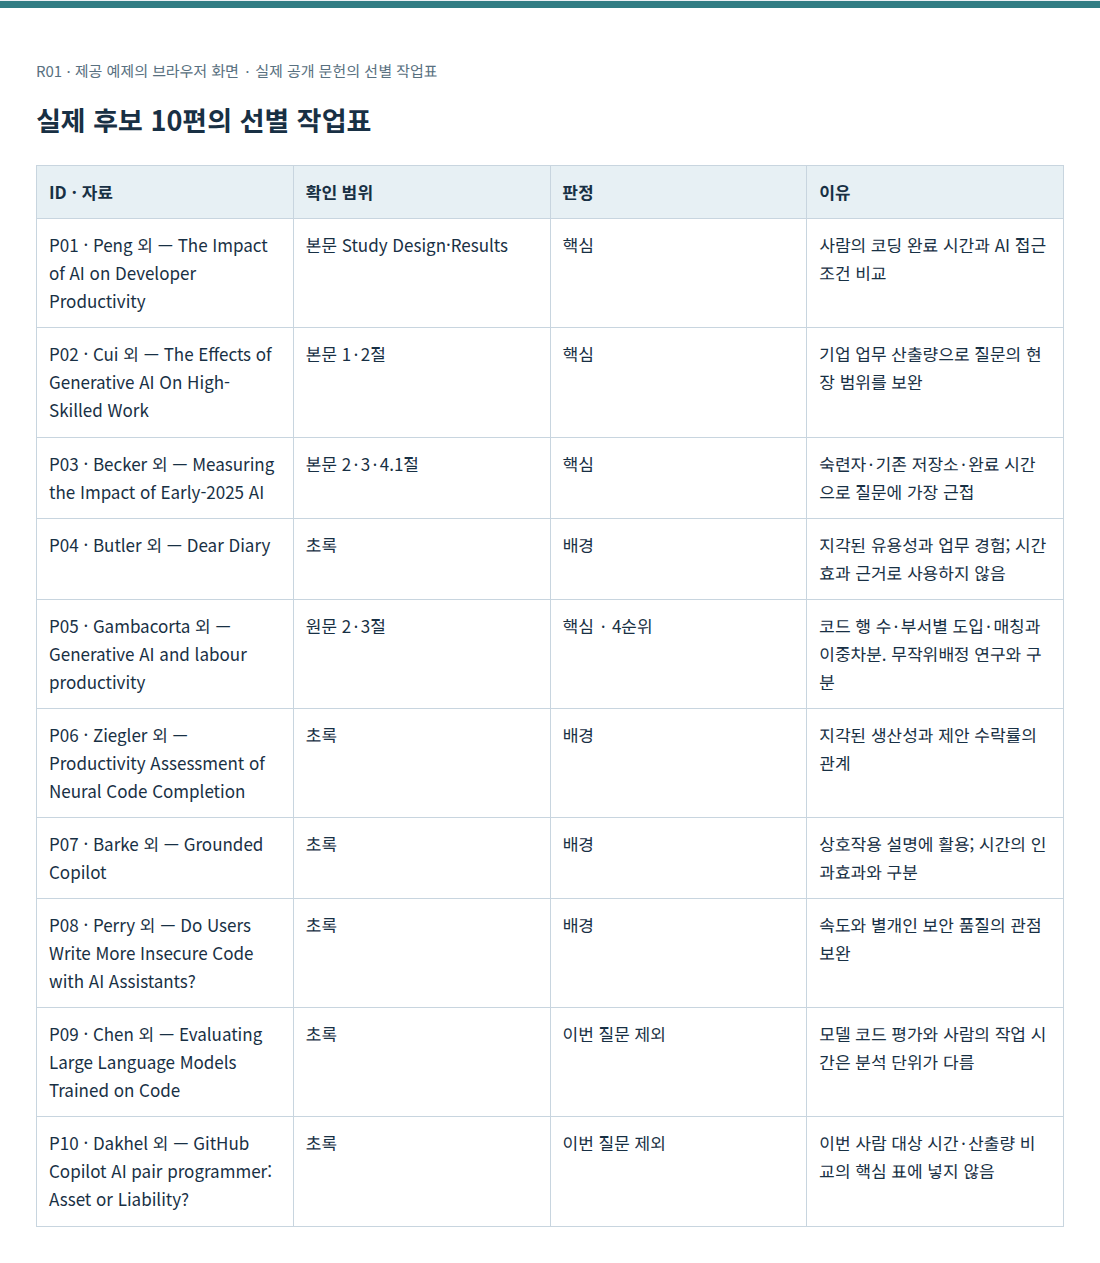
표의 열은 ID, 논문명, URL, 확인 범위, 판정, 이유, 읽기 순서예요. 핵심은 “왜 뺐는가”만큼 “어디까지 읽고 판단했는가”를 적는 거예요. 제목과 초록을 본 자료에 ‘원문 검토 완료’를 붙이면 나중에 그 행을 사실 확인으로 착각하게 돼요.
판정은 핵심, 배경, 이번 질문 제외, 확인 대기로 나눴어요. 사람이 코딩하고 시간이나 산출량을 비교한 자료는 핵심 후보예요. 인식·상호작용·보안에 관한 자료는 생산성 효과의 직접 근거와 구분해 배경에 두었어요. 모델만 평가한 연구는 이번 질문에서 제외하고, 비교군 구성이 아직 불명확한 자료는 확인 대기로 남겼어요.
실제로 Peng 외 연구의 Study Design은 개발자에게 표준 코딩 과제를 주고 도구 접근 여부를 비교해요. 그래서 P01을 핵심으로 두었어요. Becker 외 연구의 2절은 기존 저장소에서 일하는 개발자를 다루므로 P03도 핵심이에요. 제목의 ‘생산성’이라는 단어보다 대상과 작업이 판정에 기여했어요.
반면 Ziegler 외 초록은 지각된 생산성과 사용 데이터를 연결해요. 이 자료를 버릴 필요는 없지만, 작업 시간이 얼마나 달라졌는지 설명하는 핵심 표와 섞지 않아요. P06의 이유 칸은 “질이 낮음”이 아니라 “지각된 생산성의 배경 설명”이에요. 같은 자료가 질문에 따라 다른 위치를 가질 수 있어요.
초록 판정을 원문에서 한 번 더 좁혀요
P02의 제목만 보면 일반적인 효과 연구로 보이지만 Cui 외 원문 1절과 각주 4는 실제 사용의 효과를 추정하는 방식과 주간 완료 작업량을 설명해요. 원문을 확인한 뒤 이유를 “개발자 생산성”에서 “기업 업무 산출량으로 현장 범위를 보완”으로 고쳤어요. 완료 시간과 산출량을 같은 숫자로 취급하지 않도록 미리 표시한 셈이에요.
P05는 초록만 읽었을 때 ‘비교군·배정 설명 확인’으로 보류했어요. 추가로 BIS 원문 2·3절을 읽으니, 특정 부서의 도입 집단과 다른 부서의 비교집단을 성향점수 매칭과 이중차분으로 비교한다는 사실을 확인했어요. 논문에 등장하는 무작위 표본 추출을 도구 접근의 무작위 배정으로 읽으면 안 돼요. 이 원문 확인으로 P05를 ‘확인 대기’에서 ‘핵심’으로 옮기되, 설계와 결과변수의 차이를 이유 칸에 남겼어요. 핵심에 넣었다는 것은 효과 추정의 모든 가정을 검증했다는 뜻이 아니에요.
이제 핵심 4편, 배경 4편, 이번 질문 제외 2편, 확인 대기 0편으로 총 10편이에요. 이번 주 세 편과 핵심 후보 수는 달라도 괜찮아요. P05는 코드 행 수와 비무작위 도입의 해석을 보완하는 네 번째 순서로 남겼어요. 제목이 비슷한 판본은 식별자로 묶어 한 연구로 세고, 원문을 못 읽은 행을 분류 합계에서 지우지 않아요.


이번 주 순서는 ‘가장 가까운 조건’부터 정해요
가상의 독자가 기존 코드베이스에서 일하는 개발자를 연구하려 한다고 정했으므로 P03부터 읽어요. 다음에 P01을 읽으며 표준 과제와 현장 과제의 차이를 비교하고, P02에서 시간 대신 업무량을 측정할 때 생기는 문제를 확인해요. 아직 정확한 측정 방법을 못 정한 단계라면 이 순서가 질문을 구체화하는 데 도움이 돼요. 반대로 새로운 코딩 과제의 입문자를 연구한다면 P01이 먼저예요.
질문이 바뀌면 남길 논문도 다시 계산해요
이번 선별을 그대로 다른 연구계획에 복사해 보면 어떤 행이 먼저 틀어질까요? 조건 변경표 (ZIP: selection-scenarios.csv)는 같은 네 핵심 후보를 다른 질문에 적용한 작성자 판단이에요.
| 바뀐 질문·제약 | 남길 핵심과 읽기 순서 | 달라지는 판단 |
|---|---|---|
| 기존 저장소의 시간과 업무 산출량을 넓게 비교 | P03 → P01 → P02, 다음 P05 | 원래 질문이에요. 서로 다른 지표와 설계를 따로 읽어요. |
| 접근 허용의 무작위배정 연구만 검토 | P03 → P01 → P02 | P05는 배경으로 내려요. 표본을 무작위로 뽑았다는 설명만으로 포함하지 않아요. |
| 작업 완료 시간만 비교 | P03 → P01 | 주간 완료 작업량인 P02와 코드 행 수인 P05는 배경이에요. 세 편을 채우기 위해 끼워 넣지 않아요. |
| 기업 업무 산출량의 측정 방식을 설계 | P02 → P05 | 시간 연구 P01·P03은 배경이 되고, 단위 정의와 도입 조건이 먼저예요. |
이 표는 효과가 큰 연구에 우선순위를 주는 방식과 달라요. 효과 크기부터 고르면 내 결론과 맞는 연구를 남길 수 있지만, 질문을 바꿨을 때 무엇을 다시 읽어야 할지 설명하기 어려워요. 이번 방식에서는 질문 변경 → 측정값·비교 설계 변경 → 판정 변경이 추적돼요. 다만 같은 질문에서도 두 연구자의 판단은 다를 수 있으므로, 중요한 고찰이라면 독립 선별과 불일치 조정이 따로 필요해요.
첨부 폴더에서 python3 verify-screening.py를 실행하면 후보 10개, 고유 URL 10개, 판정 합계 10개와 시나리오별 핵심 ID를 확인해요. 이 검사는 행 누락·중복·범위를 벗어난 ID를 찾는 검사예요. 논문의 질이나 선별 판단을 자동으로 승인하지는 않아요. 대조 기록 (ZIP: source-check.md)에는 P05를 보류한 이유와 원문 확인 후 달라진 결정을 함께 남겼어요.
시간이 부족해도 초록만 보고 제외할 수 없는 자료를 억지로 제외하지 않아요. 확인 대기 목록을 따로 두고, 원문 접근이 막히면 저자의 공개판·기관 저장소를 찾거나 해당 판단을 미뤄요. ‘읽지 못함’과 ‘질문에 맞지 않음’을 구분해야 검색을 다시 할 때 같은 일을 반복하지 않아요.
자기 자료에 적용할 때는 질문 한 문장을 먼저 적고, 후보마다 측정값과 확인 범위를 채운 뒤 네 판정을 붙여 보세요. 핵심이 한 편도 없다면 논문 수를 채우기 전에 질문이나 검색식을 고칠 차례예요. 핵심이 너무 많다면 대상·환경·결과변수 중 어느 범위가 아직 넓은지 살펴보면 돼요. 다음 단계인 세 논문 비교에서는 남긴 세 편의 숫자를 바로 평균내지 않고 조건부터 맞춰 볼 거예요.
자료 확인일은 2026년 10월 13일이에요. 공개 원문의 필요한 절을 확인한 네 편과 초록만 읽은 여섯 편은 CSV에서 구분했어요. 예제의 선별은 작성 과정의 판단이며 독립된 두 연구자의 선별 일치도를 검증한 결과는 아니에요.
예제 파일을 한 번에 받아 다시 확인해요
이 글의 입력·코드·완성 자료 ZIP을 새 폴더에 풀면 R01/README.txt, replay.py, assets 폴더가 함께 생겨요. 개별 코드 파일만 저장하면 보조 모듈이나 입력이 빠질 수 있으므로 처음에는 이 묶음을 사용하세요. R01 폴더에서 다음 명령을 실행하면 본문에 사용한 검사를 순서대로 수행해요.
python3 replay.py
확인할 결과는 후보10편·핵심4/배경4/제외2예요. 명령이 성공해도 이 값과 본문의 적용 범위를 함께 대조하세요. 실행 안내 (ZIP: README.txt)에 필요한 파일과 개별 명령을 적었어요. 실행 코드는 verify-screening.py (ZIP: verify-screening.py)에서 직접 볼 수 있어요. Python3.12의 표준 라이브러리를 사용하며, 명령이 실패하면 ZIP의 폴더 구조와 오류에 나온 파일부터 확인해요. 실제 앱 실행에 필요한 프로그램은 원래 설명을 따르세요.
작성·확인: Codex가 공개 원문 또는 공식 문서를 확인하고 예제와 초안을 작성했어요. 사람을 대상으로 한 사용성 검증은 수행하지 않았어요.
설명 삽화 2장은 GPT로 생성한 개념 설명이에요. 실제 예제의 작업 화면과 실행 결과는 기존 그림·첨부 자료에서 따로 확인할 수 있어요.