어제 만든 그래프는 있는데, 오늘 같은 숫자를 다시 구하려니 막혀요. 비슷한 이름의 파일이 여러 개 있고, 빈칸을 어떻게 처리했는지도 기억나지 않아요. 결과가 틀렸다는 뜻은 아니지만, 지금 남은 자료만으로는 어떤 과정을 거쳤는지 설명하기 어려운 상태예요.
ADHD가 있는 성인은 계획과 정리, 큰 과제를 이어가는 데 어려움을 겪을 수 있어요. 미국 국립정신건강연구소(NIMH)의 성인 ADHD 안내에도 이런 어려움이 설명되어 있어요. 연구에서 겪는 양상은 사람과 환경에 따라 달라요. 여기서는 분석 결과 옆에, 다음 날 다시 확인할 수 있는 기록을 남기는 방법을 살펴볼게요.
새로운 관리 도구를 익히는 대신, 지금 쓰는 연구 노트나 프로젝트 문서에 짧은 기록을 붙여볼 거예요. 입력값부터 계산 결과까지 보이는 작은 연습 자료로 시작해요.
1. 결과 숫자만 있으면 무엇이 빠질까요?
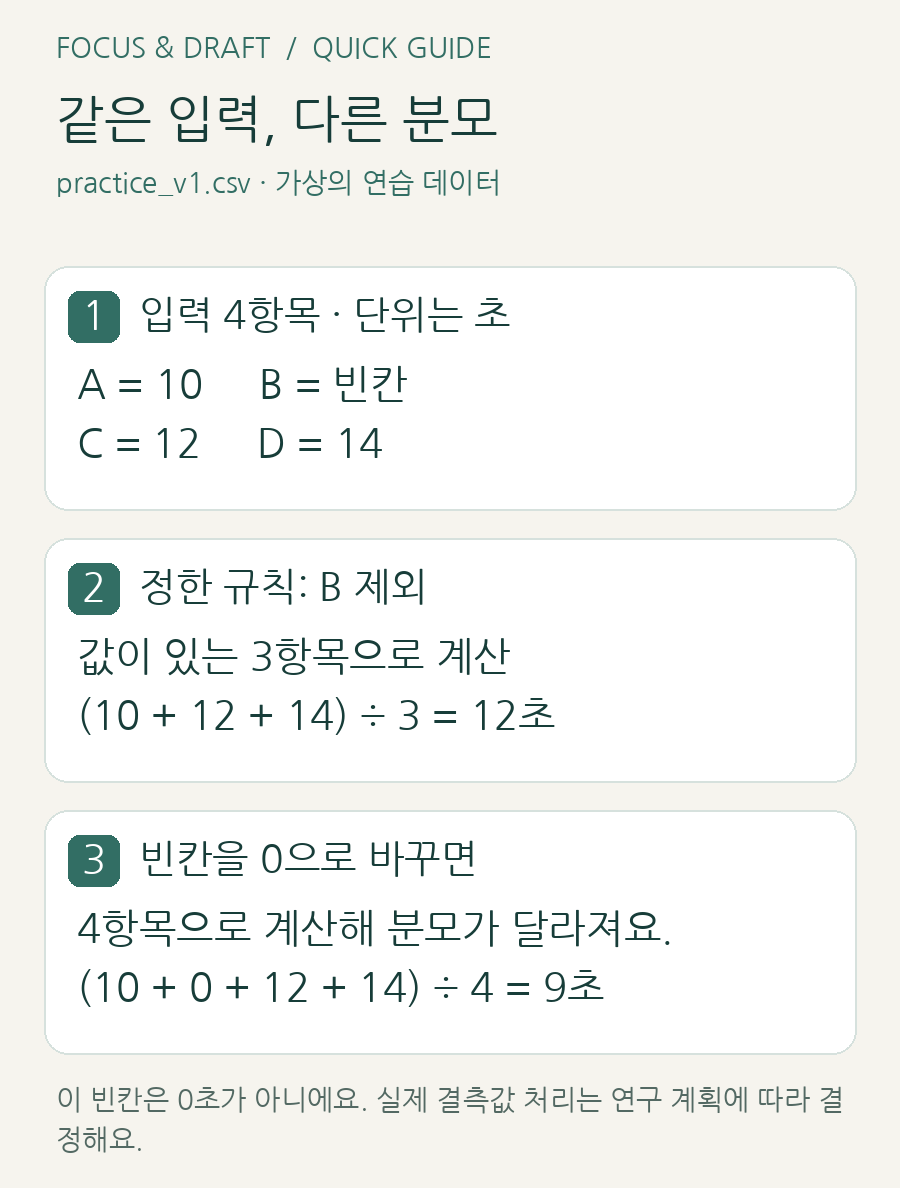
아래는 실제 참여자나 실험에서 가져오지 않은 연습용 데이터예요. 파일 이름을 practice_v1.csv라고 하고, 작업 완료 시간을 초 단위로 기록했다고 가정해볼게요.
- A: 10초
- B: 빈칸
- C: 12초
- D: 14초
이번 연습의 계산 규칙은 “값이 기록된 세 항목만으로 평균을 구하고, 빈칸이 있는 B는 계산에서 제외한다”로 미리 정해요. 그러면 계산은 다음과 같아요.
기록된 값의 합: 10 + 12 + 14 = 36초
계산에 포함한 항목: 3개
평균: 36 ÷ 3 = 12초
그런데 결과를 “평균 12초”라고만 저장하면, 다음 날에는 B를 제외했는지, 다른 값으로 채웠는지 알기 어려워요. 누군가 빈칸을 0으로 바꾸고 네 항목의 평균을 계산하면 36 ÷ 4 = 9초가 나와요. 입력값과 처리 규칙을 함께 남겨야 두 결과가 왜 달라졌는지 설명할 수 있어요.
이 예제의 빈칸은 0초를 뜻하지 않아요. 실제 연구에서 결측값을 어떻게 다룰지는 발생 원인과 연구 설계, 분석 계획에 따라 정해야 해요. 여기서 B를 제외한 것은 계산 과정을 보여주기 위한 연습 규칙이지, 모든 결측값을 삭제하라는 제안은 아니에요.
2. 분석을 마칠 때 다섯 줄을 채워요
결과를 저장한 직후, 같은 프로젝트의 연구 노트에 아래처럼 적어보세요. 파일은 프로젝트의 공용 규칙에 맞는 폴더에 두고, 노트에서는 다시 열 수 있는 링크나 위치를 연결해요.
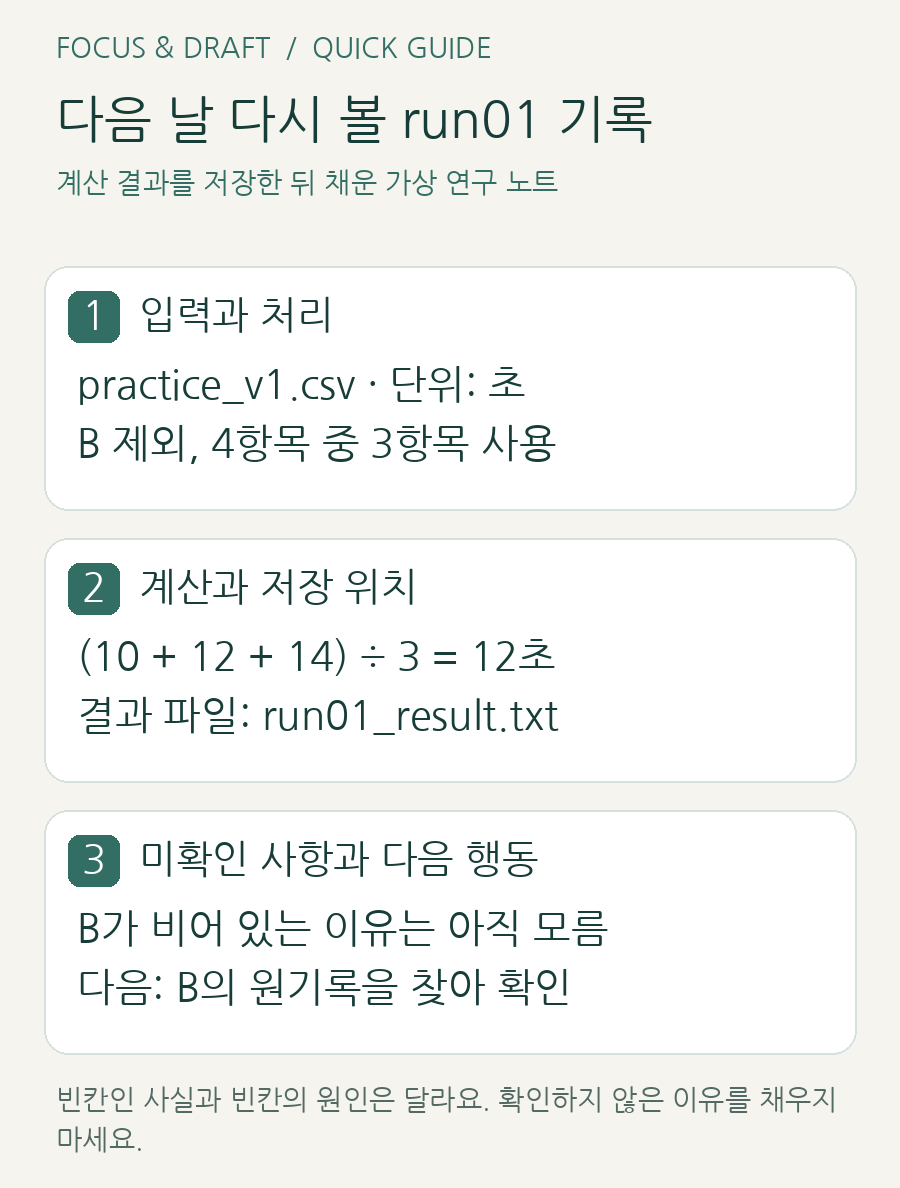
입력: practice_v1.csv. A=10, B=빈칸, C=12, D=14. 단위는 초.
처리: 연습 규칙에 따라 B를 제외함. 원본 4항목 중 값이 있는 3항목을 계산에 사용함.
계산·결과: (10+12+14)/3=12초. 계산 결과를 run01_result.txt에 저장함.
아직 모르는 것: B가 비어 있는 이유. 누락 원인은 이 파일만으로 확인할 수 없음.
다음 확인: B의 원기록을 찾아 실제 누락인지, 입력 과정의 문제인지 확인하기.
“확인했다”와 “아직 확인하지 않았다”를 구분하는 것이 중요해요. B가 비어 있다는 사실은 파일에서 확인했지만, 왜 비었는지는 모르고 있어요. 이 상태에서 “측정 실패라 제외했다”고 적으면 기록에 없던 이유를 만들어낸 셈이 돼요.
아직 결과 파일을 저장하지 않았다면 “저장함”이라고 쓰지 말고 “계산 확인, 파일 저장 전”이라고 적어요. 기록의 문장을 실제 진행 상태와 맞춰야 다음 행동을 고를 수 있어요.
UK Data Service의 데이터 문서화 안내는 시간이 지난 뒤 데이터를 다시 사용하는 연구자에게도 데이터의 의미와 연구 과정에 관한 설명이 필요하다고 안내해요. 위 다섯 줄은 그 취지를 작은 연습에 적용한 예시예요. 연구 분야에서 요구하는 정식 실험 노트나 분석 기록 전체를 대체하지는 않아요.
3. 파일 이름과 실제 실행 조건을 연결해요
파일 이름에 “최종”을 붙이는 것만으로는 어떤 분석인지 알 수 없어요. 이번 예제에서는 원본과 결과의 역할을 나누고, 기록에 둘의 관계를 남겨요.
- practice_v1.csv: 입력 데이터. 분석 결과를 맞추려고 원본의 빈칸을 덮어쓰지 않아요.
- run01_result.txt: 이번 계산의 결과와 사용한 항목 수를 저장해요.
- 프로젝트 연구 노트의 run01 항목: 입력 파일, 처리 규칙, 결과 파일, 미확인 사항을 연결해요.
이 파일 이름 자체가 표준은 아니에요. 이미 연구실에서 정한 이름과 폴더 구조가 있다면 그 규칙을 이용하세요. UK Data Service의 파일·작업 흐름 관리 안내도 일관된 파일 관리와 팀에서 합의한 정리 방식을 강조해요.
실제 분석에 코드를 썼다면 입력 파일 이름만으로는 부족해요. 실행한 코드의 버전, 바꾼 매개변수, 필요한 실행 환경도 프로젝트 기록과 연결해야 해요. 예를 들어 같은 스크립트 이름을 유지한 채 내용만 고쳤다면 이름만 적어서는 어제의 실행을 구별할 수 없어요. 이번 손계산 예제에서는 계산식 자체를 기록했지만, 복잡한 분석에서는 그 역할을 실행 코드와 설정 기록이 맡아요.
4. 다음 날에는 ‘다시 분석’보다 ‘대조’부터 해요
다음 날 결과가 9초로 나왔다고 해볼게요. 숫자만 보고 둘 중 하나를 지우거나, 어제와 같아질 때까지 값을 바꾸지 마세요. 기록을 옆에 놓고 순서대로 비교해요.
- 같은 입력인가요? practice_v1.csv의 네 항목을 확인해요. 다른 버전을 열었다면 먼저 그 차이를 살펴봐요.
- 같은 규칙인가요? 어제는 B를 제외했는데 오늘은 0으로 채웠다면, 계산 대상이 달라졌어요.
- 분모가 같은가요? 어제는 3, 오늘은 4라면 12초와 9초의 차이가 여기서 생겨요.
연습 규칙대로 계산하려면 B를 제외한 세 값의 평균을 구하면 돼요. 다만 12초가 나온다고 해서 B의 누락 원인까지 확인된 것은 아니에요. 계산 재현과 데이터 문제 해결은 각각 확인해야 해요. 다음 행동은 여전히 B의 원기록을 찾는 일이에요.
결과 옆에 남길 설명도 “평균은 12초다”에서 한 걸음 더 나아갈 수 있어요.
연습 데이터 4항목 중 값이 있는 3항목의 평균은 12초다. 빈칸 B는 정해둔 연습 규칙에 따라 계산에서 제외했으며, 빈칸의 원인은 아직 확인하지 않았다.
이 문장에는 계산에 사용한 범위와 남아 있는 질문이 함께 있어요. 다른 사람이 결과를 읽을 때도 네 항목을 모두 계산한 값으로 오해할 가능성을 줄일 수 있어요.
기록이 밀릴 때는 다음에 열 위치부터 남겨요
집중이 끝난 뒤 긴 기록을 작성하기 어렵다면, 결과를 저장할 때 짧은 문장부터 붙여보세요.
run01: practice_v1, B 제외, 3개 평균 12초. B 누락 원인 확인 전.
이 한 줄은 빠진 세부 기록을 나중에 보완할 출발점이에요. 코드와 설정까지 모두 남겼다는 뜻은 아니므로, 필요한 기록은 프로젝트 기준에 따라 이어서 채워요.
과제의 범위 자체가 흐릿하다면 공동연구자나 지도자와 이번 작업의 완료 조건을 정해볼 수도 있어요. NHS의 성인 ADHD 안내는 글로 된 지시와 과제의 계획·구조화를 돕는 지원을 예로 들어요. 예를 들어 “이번에는 평균값만 정리하면 되는지, 누락 원인 확인까지 필요한지 정하고 싶어요”라고 요청할 수 있어요.
이 글의 양식은 분석을 이어가기 위한 기록 제안이며 ADHD 치료법은 아니에요. 지금 남아 있는 결과 하나를 골라 어떤 입력을 썼고, 무엇을 바꿨으며, 아직 무엇을 모르는지 적어보세요. 모르는 칸을 추측으로 채우지 않는 것까지가 기록의 일부예요.
같은 입력으로 직접 다시 계산해봐요
본문의 계산을 손으로 확인한 뒤, 아래 CSV를 practice_v1.csv라는 이름으로 저장해도 돼요. 실제 연구자료가 아닌 네 항목의 연습 데이터예요. 아래 Python 3 코드는 외부 패키지 없이 이 파일을 읽고, 사용한 행 수와 제외한 ID까지 출력해요.
id,seconds
A,10
B,
C,12
D,14
"""Reproduce the article's fictional four-row calculation; never change its input."""

import csv
from decimal import Decimal, InvalidOperation
from pathlib import Path


def calculate(path):
    included, excluded, seen = [], [], set()
    with Path(path).open(encoding="utf-8-sig", newline="") as stream:
        reader = csv.DictReader(stream)
        if reader.fieldnames != ["id", "seconds"]:
            raise ValueError("CSV 첫 줄은 id,seconds여야 해요.")
        for row in reader:
            key = (row.get("id") or "").strip()
            if not key or key in seen or None in row or row.get("seconds") is None:
                raise ValueError("ID가 비었거나 중복되었거나 열 수가 다릅니다.")
            seen.add(key)
            raw = row["seconds"].strip()
            if not raw:
                excluded.append(key)
                continue
            try:
                value = Decimal(raw)
            except InvalidOperation as exc:
                raise ValueError(f"{key}: 숫자를 확인하세요.") from exc
            if not value.is_finite() or value < 0:
                raise ValueError(f"{key}: 0 이상의 유한한 초 값을 사용하세요.")
            included.append(value)
    if not included:
        raise ValueError("평균을 계산할 값이 없어요. 원본을 확인하세요.")
    return len(seen), len(included), excluded, sum(included) / len(included)


if __name__ == "__main__":
    total, used, missing, average = calculate("practice_v1.csv")
    print(f"원본 {total}행 / 사용 {used}행 / 빈칸 ID: {', '.join(missing) or '없음'}")
    print(f"평균: {average:.2f}초")
위 코드를 reproduce_analysis.py로 저장하고 CSV와 같은 폴더에서 실행해요. 터미널에서 아래 명령을 사용해요. Python 3가 설치되어 있지 않다면 앞의 손계산으로 확인할 수 있어요.
python3 reproduce_analysis.py
제공된 네 항목으로 실행하면 다음 두 줄이 나와요.
원본 4행 / 사용 3행 / 빈칸 ID: B
평균: 12.00초
코드는 값이 비어 있는 행만 제외해요. 0이 입력된 행은 포함하며, 숫자가 아닌 값이 있으면 계산을 멈춰요. 빈칸의 원인을 추정하지 않고 실제 연구의 결측값 처리 방법을 결정해주지도 않아요. 모든 값이 비어 있을 때는 평균을 0으로 만들지 않아요. 먼저 원본을 확인해야 하기 때문이에요.